Vimpo 博客 · 2026 年 10 月 16 日
我们是怎么把长字幕切短的
语音识别出来的字幕,经常一条就是三行原文加三行译文,盖住小半个画面,一挂就是十几秒。看画面的时候,字幕已经讲到后面去了;读字幕的时候,又不知道现在说到了哪一句。
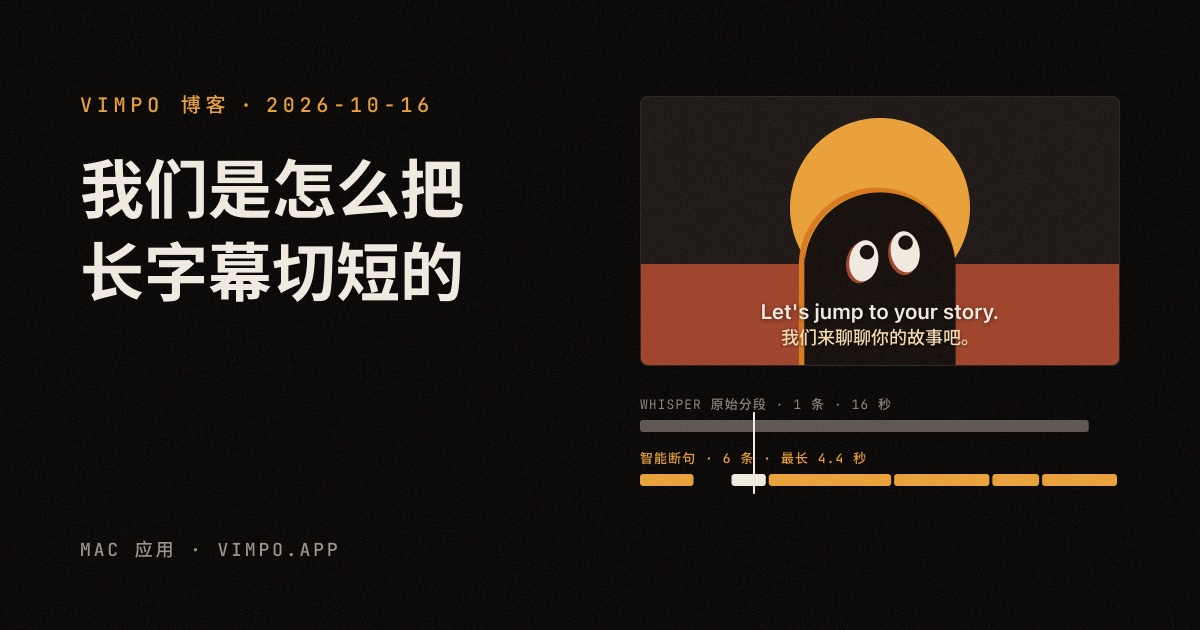
下面是一段访谈里的 17 秒,左边是原来的样子,右边是现在的样子:
16 岁的年轻人。我们来聊聊你的故事吧。你从小就非常聪明,比如参加数学奥林匹克。带我们回到那个时期的 Alex 吧,你当时是什么感觉?在想什么?是什么驱使你走上这条路?
16 year olds in this audience, you know. Let's jump to your story. I mean, you came up always really smart, like Math Olympiad. Like, jump us to, you know, the Alex of that time. Like, what were you feeling? What were you thinking? And what drove you down this road?
1 条字幕,一直挂 16 秒
在场的观众里还有 16 岁的年轻人。
there's some 16 year olds in this audience, you know.
6 条字幕,每条 1–4 秒,跟着说话切换
长字幕是从哪来的
Vimpo 用 Whisper 在你的 Mac 上把语音转成字幕。Whisper 会把识别结果分成一段一段,每段带着起止时间,我们原来直接把一段当成一条字幕。
问题是,这些分段是按 Whisper 处理音频的方式划的,不是按人说话的方式。碰上说话快、停顿少的人,一段能有十几秒、几百个字符。上面那段访谈的前 6 分钟,Whisper 一共给了 27 段,平均每段 13 秒、213 个字符,最长的一段 28 秒、453 个字符。翻译又是一行对一行的,英文有多长,中文就跟着有多长。
最直接的办法为什么不行
最先想到的是两个最直接的办法。
- 按字数硬切。whisper.cpp 自带一个
max_len参数,超过多少字符就切开。可它只看长度,经常切在「the | Alex」这样的地方。 - 交给大模型。大模型最懂语义,断出来的句子也最自然。但它不知道每个词是在第几秒说的;就算告诉它「只断句,别改字」,它还是会顺手改词、删掉口头禅,一改就和时间对不上了。而且得联网,还得先配好 API.
后来我们想明白了,断句其实要回答两个问题:在哪里断最自然,以及断开之后每一半从第几秒开始。这两个问题,刚好可以分别交给 Apple 的 NaturalLanguage 和 Whisper.
第一步:让 Whisper 记下每个词的时间
whisper.cpp 支持一种叫 DTW 的词级时间戳。它会读取模型里几个特定注意力头的权重,看每个字在生成的时候最关注音频的哪个位置,再把文字和音频对齐成一条时间线。这样每个词都有了自己的时间,比如「So」在 16.30 秒,「why」在 16.60 秒。
这里有个小坑。第一次跑的时候,所有词的时间都是 -1. 原因是 whisper.cpp 默认开着 Flash Attention, 它为了快,从来不会把完整的注意力矩阵存下来,DTW 自然就拿不到数据。所以开启智能断句时,Vimpo 会关掉 Flash Attention. 代价是识别会慢一点:在我们的测试里,6 分钟的音频大约从 12 秒变成了 14 秒。
第二步:用 NaturalLanguage 读懂句子
有了时间,接下来要知道句子长什么样。macOS 自带的 NaturalLanguage 框架能把一段文字切成句子和词,还能标出每个词的词性:名词、介词、连词、冠词……它也支持中文分词,不需要额外下载任何模型。
做法是先在句末和明显的停顿处切开。剩下还太长的句子,就给每两个词之间的位置打分,在分数最高的地方断开,再对两半继续处理,直到每条字幕都不超过一两行。打分的规则大概是这样:
- 后面跟着逗号、分号:加分。
- 两个词之间有停顿:加分,停得越久加得越多。说话的人换气的地方,往往就是最自然的断点。
- 下一个词是 and、but、because 这样的连词:加分,新的从句从这里开始。
- 这个词是 the、of、to 这样的冠词或介词:减分,它们不能留在行尾。
- 形容词和名词之间:减分,不能把一个词组拆到两行。
- 两半长短差不多:加分;任何一边太短:减分。
最后再收个尾:太短的碎片并回相邻的那一条;每条字幕提前 0.2 秒出现、多停 0.3 秒,给眼睛留一点读的时间。
中文有点不一样
中文视频的情况又不太一样:Whisper 识别出来的中文几乎没有标点。我们测试的一段 6 分钟中文播客,一个标点都没有。没有标点,就没法按句子切。
好在停顿还在,NaturalLanguage 的中文分词和词性也很准。所以中文主要看停顿,再加上「但是」「所以」「其实」「比如说」这类口语里常用来开启新一句的词。另外还有几条专门照顾中文的规则:不在「的」后面断开,不把「一」和「个」拆开,不让「这个」「那个」留在行尾。
Whisper 原始分段8.5 秒 · 49 字
就是没想到说原来在中国市场上其实最早在播客里能跑出来的商业模式居然是直接给品牌做他们的内容的服务商
智能断句3 条
1:10.2就是没想到说原来在中国市场上
1:12.6其实最早在播客里能跑出来的商业模式
1:14.9居然是直接给品牌做他们的内容的服务商
效果
同一期访谈的前 6 分钟,字幕从 27 条变成了 127 条,平均每条 2.7 秒、44 个字符,最长的一条也只有 5 秒。那段中文播客的 6 分钟切成了 141 条,每条不超过 22 个字。
时间准不准,我们是这样验证的:随机挑几条字幕,按它们的起止时间把音频切出来,再交给 Whisper 重新识别一遍。听出来的内容和字幕基本一致,没有出现提前、滞后或者吃掉半句的情况。
还不完美的地方
- 中文里大约 5% 的断点不太理想,多半是说话的人自己在那里停顿或者改口,光靠规则判断不了语义。
- 它只作用于之后用语音识别生成的字幕。已经生成的字幕要重新识别一次才会变短,视频自带的字幕保持原样。
- 开启后识别会稍慢一点。
那 5% 恰好是大模型最擅长的。我们在考虑以后加一层:开了 AI 翻译的话,让模型帮忙微调断句,时间仍然由 Whisper 给出。
怎么打开
智能断句默认是关闭的。下载视频时的「下载后」,或者导入视频时的「导入后」,语音识别下面都有一个「智能断句」勾选框。点旁边的「看效果」,就能看到文章开头那个对比。
整个过程都在你的 Mac 上完成,不需要联网。